Casos prácticos: los errores más comunes al desarrollar estrategias de trading con IA
Permítame mostrarle dos situaciones que he visto repetirse una y otra vez a lo largo de mi carrera. Cambian los nombres, cambian los mercados y cambian las herramientas utilizadas, pero el desenlace suele ser exactamente el mismo.
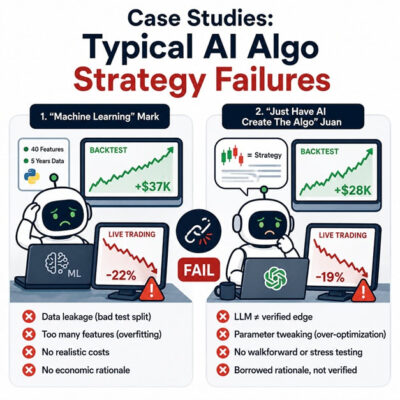
Caso 1: «Mark», el entusiasta del Machine Learning
La situación. Imaginemos a un trader al que llamaremos Mark. Lleva tres años operando futuros del E-mini S&P 500 (ES). Después de escuchar hablar constantemente sobre inteligencia artificial, decide construir su propia estrategia mediante Machine Learning. Aprende algunos conceptos básicos, instala Python y comienza a desarrollar su modelo.
La construcción del modelo. Mark recopila cinco años de datos diarios del ES (apertura, máximo, mínimo, cierre y volumen) y genera 40 variables de entrada, utilizando prácticamente todos los indicadores técnicos que encuentra, además de varias combinaciones propias.
Posteriormente divide los datos en un conjunto de entrenamiento (80%) y otro de prueba (20%), entrenando un algoritmo de Gradient Boosting para predecir si el cierre del día siguiente será superior o inferior a la apertura.
La primera evaluación arroja un 58% de aciertos. Como ha leído en Internet que cualquier porcentaje superior al 55% puede ser rentable, considera que el resultado es prometedor.
Después optimiza los hiperparámetros mediante validación cruzada y consigue elevar la precisión hasta el 61%.
El backtest. A continuación desarrolla un sistema muy sencillo: compra cuando el modelo predice una subida, vende cuando predice una caída y cierra todas las posiciones al final de la sesión.
Los resultados parecen extraordinarios. Una cuenta inicial de 10.000 dólares habría crecido hasta 47.000 dólares en cinco años, con una rentabilidad anual cercana al 36%, un drawdown máximo del 12% y un ratio Sharpe de 1,8.
Mark muestra orgulloso la curva de resultados a sus amigos. Todos quedan impresionados.
Opera en simulación durante dos semanas, obtiene algunos beneficios y decide comenzar a invertir dinero real.
La realidad.
Primer mes: -4%.
Segundo mes: -6%.
Tercer mes: -3%.
Seis meses después acumula una pérdida cercana al 22% y la estrategia no muestra ningún síntoma de recuperación.
¿Qué ocurrió?
Error nº 1: contaminación del conjunto de prueba.
Mark utilizó la validación cruzada para optimizar los hiperparámetros, lo que significa que el supuesto conjunto de prueba dejó de ser realmente independiente. Sin darse cuenta, utilizó esos datos para tomar decisiones de optimización, invalidando completamente la evaluación fuera de muestra (out-of-sample).
Es uno de los errores más frecuentes y menos comprendidos dentro del desarrollo de estrategias con inteligencia artificial.
Error nº 2: la maldición de la dimensionalidad.
Cuarenta variables para apenas cinco años de datos diarios resultan claramente insuficientes. El algoritmo encontró relaciones que explicaban perfectamente esas aproximadamente 1.250 sesiones bursátiles, pero la inmensa mayoría de esos patrones eran simplemente ruido estadístico.
Error nº 3: costes de ejecución irreales.
El backtest utilizó precios perfectos, sin considerar deslizamientos (slippage) ni comisiones.
Una estrategia que apenas resulta rentable en un entorno ideal puede convertirse fácilmente en perdedora cuando se incorporan costes de ejecución realistas.
Error nº 4: ausencia de una justificación económica.
Mark nunca se planteó una pregunta fundamental:
¿Por qué debería existir realmente esa ventaja estadística?
¿Qué mecanismo del mercado genera ese patrón? ¿Qué hace pensar que seguirá funcionando en el futuro?
Sin una explicación lógica detrás del comportamiento observado, no existe ninguna razón para esperar que ese supuesto patrón continúe apareciendo.
La historia de Mark no es una excepción.
Es la norma.
Su espectacular backtest fue consecuencia directa de un modelo construido, sin saberlo, para ofrecer precisamente ese resultado. Lo que realmente estaba operando no era una ventaja estadística, sino una colección de patrones aleatorios disfrazados de alfa.
Caso 2: «Juan», el trader que dejó que ChatGPT diseñara su estrategia
Existe otra variante muy habitual del mismo problema.
El desenlace vuelve a ser idéntico, aunque el camino sea diferente.
La situación. Juan lleva un par de años operando futuros del petróleo. No sabe programar y el Machine Learning le parece demasiado complejo.
Sin embargo, escucha que ChatGPT puede generar estrategias de trading y decide probar suerte.
La idea.
Escribe el siguiente mensaje:
«Genera una estrategia rentable para futuros del petróleo utilizando indicadores técnicos e incluye reglas claras de entrada y salida para poder hacer un backtest.»
ChatGPT responde inmediatamente proponiendo un sistema basado en un RSI de 14 periodos combinado con un cruce de medias móviles de 50 periodos, acompañado de un stop fijo de 1.500 dólares y un objetivo beneficio/riesgo de 2:1.
Además, explica con total seguridad que la estrategia aprovecha el impulso del mercado mientras filtra gran parte del ruido.
Todo parece perfectamente razonable.
Juan copia las reglas directamente en su plataforma y ejecuta el backtest.
El backtest.
Tras analizar cinco años de datos obtiene una curva de resultados bastante atractiva.
Los 10.000 dólares iniciales se convierten en 38.000 dólares, con una rentabilidad anual aproximada del 28%, un drawdown máximo del 18%, un porcentaje de aciertos del 52% y un ratio Sharpe cercano a 1,4.
No tan espectacular como el sistema de Mark, pero suficientemente bueno.
Decide optimizar ligeramente algunos parámetros.
Cambia el RSI de 14 a 11 periodos y la media móvil de 50 a 45.
Ahora la rentabilidad sube hasta el 34% y el drawdown baja al 14%.
La estrategia parece incluso mejor.
Publica la curva de resultados en un foro de trading, recibe numerosos comentarios positivos, opera dos semanas en simulación y finalmente comienza a invertir dinero real.
La realidad.
Primer mes: -3%.
Segundo mes: -7%.
Tercer mes: prácticamente sin cambios, únicamente gracias a una operación afortunada.
Cuarto mes: -5%.
Después de seis meses acumula pérdidas cercanas al 19%.
El comportamiento del sistema no tiene absolutamente nada que ver con el magnífico backtest inicial.
¿Qué ocurrió?
Error nº 1: ChatGPT no sabe si una estrategia funciona realmente.
Este es probablemente el aspecto que más se pasa por alto.
Los grandes modelos de lenguaje (LLM) son motores de predicción de texto. Generan respuestas que parecen plausibles porque están basadas en enormes cantidades de información pública.
Cuando ChatGPT propuso aquella estrategia basada en RSI y medias móviles, no estaba apoyándose en investigaciones que demostraran su rentabilidad.
Simplemente estaba reproduciendo un tipo de estrategia muy habitual dentro del contenido disponible en Internet, incluyendo artículos escritos por personas que jamás verificaron si realmente funcionaba.
Un lenguaje convincente no equivale a una ventaja estadística demostrada.
Error nº 2: la optimización destruyó el verdadero test fuera de muestra.
Juan ya disponía de un backtest.
En el momento en que modificó los parámetros para mejorar los resultados, aquel backtest dejó de ser una prueba independiente y pasó a convertirse en una simple optimización.
Los nuevos resultados del 34% anual ya no representaban una estimación del futuro, sino únicamente la mejor versión posible del pasado.
Error nº 3: ausencia de pruebas de robustez.
Juan nunca realizó un análisis walk-forward, ni simulaciones de Monte Carlo, ni comprobó cómo habría funcionado la estrategia bajo diferentes regímenes de mercado o distintos niveles de volatilidad.
Simplemente observó una curva ascendente y dio por supuesto que era suficiente.
Error nº 4: aceptó la explicación sin verificarla.
ChatGPT afirmaba que la estrategia aprovechaba el impulso del mercado mientras eliminaba el ruido.
Suena razonable.
Pero sonar razonable no significa ser cierto.
Juan nunca investigó si el RSI realmente posee capacidad predictiva sobre el petróleo, durante qué periodos históricos ha funcionado o si esa ventaja sigue existiendo actualmente.
Confundió la explicación generada por el modelo con una auténtica investigación cuantitativa.
Y no son lo mismo.
La historia de Juan comparte exactamente el mismo problema que la de Mark.
Delegó su pensamiento en una herramienta incapaz de pensar por él.
ChatGPT hizo exactamente aquello para lo que fue diseñado: generar una respuesta convincente.
Determinar si esa respuesta refleja realmente la realidad del mercado sigue siendo responsabilidad exclusiva del operador.
La conclusión no es que no deban utilizarse modelos de lenguaje.
Yo mismo los utilizo con frecuencia y considero que son herramientas excelentes para generar ideas e investigar nuevas posibilidades.
La lección es mucho más sencilla:
Cuando un LLM le propone una estrategia de trading, únicamente le está ofreciendo una idea.
No le está entregando una estrategia rentable.
No le está proporcionando una ventaja estadística demostrada.
Mucho menos un negocio listo para producir beneficios.
Lo verdaderamente importante comienza después: validar esa idea, ponerla a prueba, someterla a condiciones extremas y comprobar rigurosamente si realmente posee una ventaja sostenible.
Y ese trabajo, al menos de momento, ninguna inteligencia artificial puede hacerlo por usted.