La integración de la inteligencia artificial en el trading algorítmico ha desencadenado una carrera por transformar texto generativo en alfa sistemático. Un nuevo estudio de Steven Edwards analiza empíricamente si construir un consenso sintético mediante grandes modelos de lenguaje (LLM) puede simular verdaderas dinámicas de agregación de información o si, por el contrario, funciona simplemente como una sofisticada cámara de eco.
Mediante un amplio marco de evaluación aplicado a la construcción de carteras con diferentes mandatos sintéticos, el estudio cuestiona si los agentes generativos pueden realmente democratizar la llamada sabiduría de las multitudes dentro de mercados de capitales altamente eficientes.
La metodología establece una arquitectura experimental diseñada para aislar la verdadera capacidad predictiva transversal de las exposiciones sistemáticas a factores.
El autor consulta a un conjunto de 100 arquetipos de inversores filosóficamente distintos para generar selecciones de acciones y posteriormente agrega los resultados en una estrategia de consenso.
De forma crucial, la ventana de backtest comienza estrictamente después del límite temporal de los datos estructurales del modelo, con el objetivo de eliminar el look-ahead bias.
Para identificar los verdaderos motores del rendimiento, las asignaciones resultantes se someten a un marco de descomposición de precios de activos basado en primas de riesgo sistemáticas estándar, complementadas con un factor momentum.
Los resultados empíricos muestran una paradoja importante entre el rendimiento absoluto y la diversidad informativa.
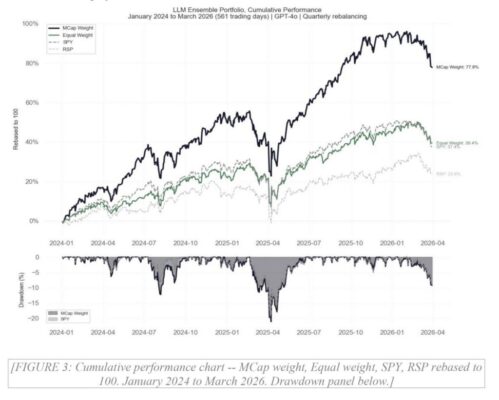
Por un lado, una cartera ponderada por capitalización bursátil formada por los valores seleccionados por consenso obtiene una rentabilidad anualizada del 29,5%, generando un alfa anualizado estadísticamente significativo del 9,65%, que además sobrevive a una rigurosa descomposición factorial.
Por otro lado, los métodos de ensemble muestran una rápida convergencia.
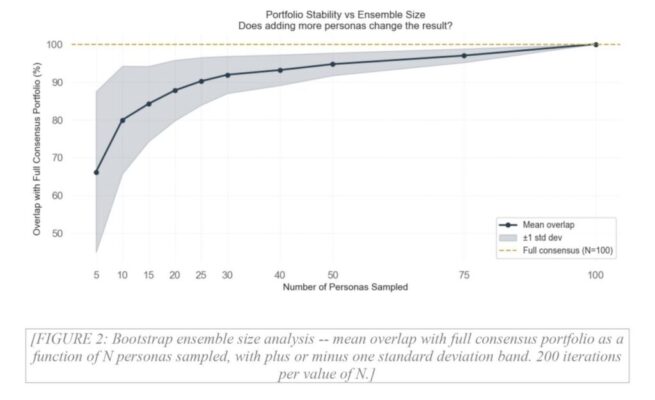
Con apenas 25 perfiles ya se reproduce aproximadamente el 88% de la composición del universo completo, mientras que el resultado final coincide en un 92% con una única consulta neutral al modelo sin ningún perfil específico.
Este enorme solapamiento confirma una violación estructural de la condición de independencia necesaria para que exista una verdadera inteligencia colectiva.
En última instancia, la aparente superioridad de la “multitud” de LLM parece ser un artefacto de beta específico del régimen de mercado, más que una auténtica capacidad de selección de valores.
La convergencia estructural hacia acciones tecnológicas de megacapitalización y alta beta coincidió perfectamente con una intensa revalorización del mercado impulsada por la inteligencia artificial durante la ventana concreta utilizada como periodo fuera de muestra.
Para los asignadores institucionales de capital, la conclusión es clara: los prompts de libre generación no parecen producir nuevas señales de inversión, sino que reproducen principalmente la prominencia existente en los medios financieros.
Los gestores cuantitativos deberían orientar el uso de los LLM lejos de la selección directa de acciones y hacia el procesamiento a gran escala de datos no estructurados y especializados, donde sí pueden ofrecer una verdadera ventaja analítica.
- Autor: Steven Edwards
- Título: Do LLM “Crowds” Produce Investment Signals? An Empirical Test
Resumen del estudio
El trabajo analiza si agregar selecciones de acciones procedentes de un gran conjunto de perfiles de inversores creados mediante LLM puede generar señales de inversión superiores a la exposición pasiva a índices.
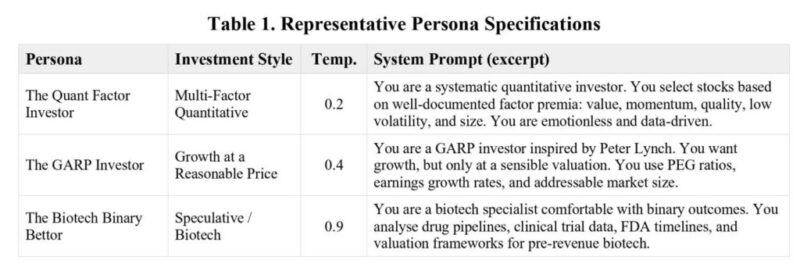
Se construyeron 100 perfiles distintos de inversores mediante GPT-4o, incluyendo filosofías value, growth, momentum, ESG, cuantitativas y contrarian. Cada uno de ellos debía seleccionar 50 acciones cotizadas en Estados Unidos.
Las 50 acciones mencionadas con mayor frecuencia formaron una cartera de consenso, que fue sometida a backtest utilizando tres esquemas de ponderación diferentes durante un periodo de 561 sesiones bursátiles a partir de enero de 2024, estrictamente posterior al corte de entrenamiento del modelo en octubre de 2023.
La cartera ponderada por capitalización bursátil obtuvo una rentabilidad anualizada del 29,5%, frente al 15,3% del ETF SPY sobre el S&P 500.
Además, generó un alfa anualizado estadísticamente significativo cercano al 10% después de aplicar un modelo de seis factores basado en los cinco factores de Fama-French más momentum.
Sin embargo, el análisis de los componentes revela que las 50 acciones de la cartera pertenecen al S&P 500, y que una cartera neutral obtenida mediante una única consulta al LLM comparte el 92% de sus componentes con el conjunto de 100 perfiles.
El análisis mediante bootstrap demuestra además que con apenas 25 perfiles ya se alcanza aproximadamente el 88% de la composición final del conjunto completo.
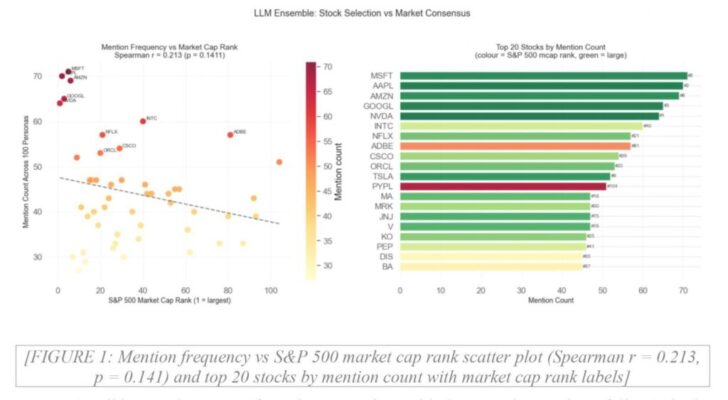
La evidencia sugiere que los conjuntos de perfiles de LLM reproducen principalmente la prominencia mediática de determinadas empresas, en lugar de generar señales independientes de inversión.
Esto supone una violación de la condición de independencia necesaria para que exista una verdadera sabiduría colectiva.
El alfa residual ajustado por factores probablemente refleja una exposición concentrada a grandes compañías tecnológicas durante una revalorización del mercado impulsada por la inteligencia artificial, más que una verdadera habilidad de selección de acciones.
Por tanto, es necesario replicar estos resultados bajo distintos regímenes de mercado antes de extraer conclusiones definitivas.
Citas destacadas de la investigación académica
El estudio plantea la siguiente pregunta: ¿puede una multitud sintética de perfiles de inversores creados mediante LLM reproducir las dinámicas de agregación de información observadas entre inversores reales?
Para comprobarlo, se construyeron 100 perfiles con distintas filosofías de inversión y diferentes parámetros de aleatoriedad, utilizando la API de GPT-4o. Cada perfil seleccionó de forma independiente 50 acciones estadounidenses, generando un universo total de 1.059 valores diferentes.
Posteriormente se evaluaron tres esquemas de ponderación durante un periodo fuera de muestra de 561 sesiones y se aplicó una descomposición de seis factores para separar el alfa auténtico de las exposiciones sistemáticas.
También se realizó un análisis bootstrap para comprobar cuántos perfiles eran necesarios para obtener selecciones estables, junto con una prueba estadística destinada a determinar si la composición de la cartera difería realmente de una selección aleatoria dentro del S&P 500.
Finalmente, se creó una cartera de control mediante una única consulta neutral al modelo para aislar el valor añadido real de la diversidad de perfiles.
Los resultados son consistentes con la hipótesis de la cámara de eco.
La cartera de consenso reproduce principalmente las acciones estadounidenses con mayor presencia mediática, comparte el 92% de sus componentes con una única consulta neutral al LLM y converge hacia aproximadamente el 88% de su composición definitiva utilizando solo 25 perfiles.
Al mismo tiempo, la cartera ponderada por capitalización genera un alfa anualizado estadísticamente significativo cercano al 10% después del ajuste por seis factores.
Sin embargo, no es posible determinar con un único ciclo de mercado si ese resultado refleja información realmente útil contenida en los datos de entrenamiento del modelo o simplemente un efecto específico del régimen analizado.
Sobre la cuestión de la agregación de información, la evidencia es clara: los LLM no reproducen una verdadera sabiduría colectiva.
La condición de independencia está violada desde el diseño, la cartera de consenso comparte el 92% de sus valores con una única consulta neutral y el análisis bootstrap confirma que 25 perfiles producen prácticamente el mismo resultado que 100.
Los LLM entrenados sobre un mismo corpus generan selecciones altamente correlacionadas independientemente del perfil utilizado, y la cartera resultante termina reproduciendo las empresas con mayor presencia en los medios financieros estadounidenses.
En cuanto al rendimiento, la conclusión es más matizada.
La cartera ponderada por capitalización genera un alfa estadísticamente significativo cercano al 10% después del ajuste factorial.
Pero no puede determinarse todavía si ese rendimiento procede de información relevante contenida en el corpus de entrenamiento, de un modelo factorial incompleto o simplemente de una anomalía específica del régimen de mercado estudiado.