Este trabajo investiga si periodos históricos de entrenamiento más largos mejoran el comportamiento fuera de muestra de un Modelo Oculto de Markov (HMM) utilizado para identificar regímenes de mercado.
Se comparan cuatro HMM gaussianos de cuatro estados que únicamente difieren en el punto de inicio de sus datos de entrenamiento —1970, 1980, 1990 y 2000—, mientras que todos se evalúan sobre el mismo periodo de prueba.
El modelo utiliza cinco variables basadas en mercado que capturan volatilidad, drawdowns, condiciones crediticias y rotación sectorial para identificar regímenes latentes de riesgo.
Los resultados muestran que seleccionar modelos únicamente por su verosimilitud fuera de muestra puede llevar a conclusiones engañosas, favoreciendo historiales de entrenamiento más cortos que no consiguen capturar correctamente los regímenes de crisis.
Cuando la evaluación incorpora estabilidad de los regímenes, interpretabilidad económica y métricas basadas en estrategias, el modelo entrenado con el historial más largo ofrece una mejor generalización y evita mejor el sobreajuste.
El estudio destaca que la metodología de validación y los criterios de evaluación son tan importantes como el diseño del modelo y la longitud de los datos a la hora de analizar modelos de inversión basados en regímenes.
Introducción
Los mercados tienden a alternar entre periodos tranquilos y favorables al riesgo —con baja volatilidad, spreads de crédito estrechos y renta variable al alza— y episodios más breves de aversión al riesgo en los que esas condiciones se invierten.
Identificar el régimen dominante es una pieza central de muchas estrategias tácticas de asignación de activos, y este estudio analiza una forma de hacerlo: un Modelo Oculto de Markov ajustado sobre variables semanales basadas en precios de mercado a lo largo de seis décadas.
La pregunta que se plantea parece sencilla: ¿entrenar con más historia mejora la generalización fuera de muestra?
Normalmente, disponer de más datos es positivo, pero las series financieras son no estacionarias y la historia más lejana podría añadir ruido procedente de estructuras de mercado que ya no existen.
Elegir si el periodo de entrenamiento comienza en 1970, 1980, 1990 o 2000 equivale, por tanto, a realizar una apuesta sobre hasta qué punto la estructura de los regímenes permanece estable a lo largo del tiempo.
Existen razones para pensar que podría serlo.
Los precios pueden seguir tendencias sin un límite claro, pero las variables que separan los distintos regímenes —nivel de volatilidad, estructura temporal de la volatilidad, amplitud de los spreads de crédito y profundidad de los drawdowns— están acotadas y tienden a revertir a la media.
Un drawdown del 40% en 1974 es esencialmente el mismo tipo de fenómeno que un drawdown del 40% en 2008.
Si esa estructura es estacionaria, disponer de más historia debería ayudar. Si no lo es, debería perjudicar.
El experimento está diseñado para distinguir entre ambas posibilidades.
Sin embargo, como muestran posteriormente los resultados, el problema más difícil no está en formular la pregunta, sino en evaluarla: la ventana de validación y la métrica de selección determinan la respuesta.
Ese aspecto, incluso más que el propio modelo, constituye la principal contribución del trabajo.
Antecedentes
Modelos ocultos de Markov
Un HMM describe un sistema que se encuentra en uno de un número reducido de estados ocultos, transita entre ellos a lo largo del tiempo y genera una señal observable cuya distribución depende del estado actual.
Los estados nunca se observan directamente; se infieren a partir de las señales observadas.
El modelo está definido por dos componentes principales.
Una matriz de transición establece la probabilidad de pasar de un estado a otro en cada periodo e incorpora la propiedad de Markov: el siguiente estado depende únicamente del estado actual.
Una distribución de emisiones para cada estado —en este caso, una distribución gaussiana multivariante aplicada al vector de variables— describe qué tipo de valores suele producir cada régimen.
Así, cada régimen se representa mediante una distribución característica de volatilidad, spreads y drawdowns, con su propia media y matriz de covarianza.
Los parámetros se estiman mediante el algoritmo Baum–Welch.
Una vez ajustado el modelo, se decodifica para etiquetar cada periodo, y la elección del método de decodificación tiene consecuencias importantes.
La estimación suavizada utiliza toda la secuencia, incluyendo información pasada y futura, mientras que la estimación filtrada utiliza únicamente los datos disponibles hasta cada momento.
Cualquier evaluación de rendimiento debe utilizar la estimación filtrada, porque la suavizada incorpora información futura y inflaría artificialmente unos resultados que no podrían haberse operado en tiempo real.
Por qué utilizar un HMM para los regímenes de mercado
Los supuestos del modelo encajan bien con el problema.
Los regímenes son latentes —solo pueden observarse a través de sus síntomas—, persistentes y discretos en lugar de continuos.
Estas son precisamente las propiedades que un HMM representa mediante un pequeño conjunto de estados, transiciones persistentes y perfiles de emisión diferenciados.
Frente a alternativas más sencillas, como utilizar un umbral sobre un único indicador o una estimación móvil de volatilidad, un HMM es multivariante, probabilístico y se calibra a partir de los propios datos.
Combina varias variables, devuelve una probabilidad de régimen en lugar de una etiqueta rígida y aprende sus parámetros de forma estadística.
Pero estas ventajas únicamente son útiles si los regímenes son suficientemente estables como para poder estimarlos de forma fiable.
Y eso nos devuelve a la pregunta principal.
Datos y variables
La selección de variables se rige por tres requisitos relacionados directamente con el objetivo del experimento.
En primer lugar, deben ser estacionarias, de manera que cada régimen pueda representarse como una nube gaussiana fija cuya media y covarianza no cambien estructuralmente a lo largo de la muestra.
Una variable con tendencia violaría el modelo de emisiones y complicaría cualquier comparación entre décadas.
En segundo lugar, deben disponer de un historial suficientemente largo, extendiéndose hasta comienzos de la década de 1960.
De otro modo, no sería posible analizar correctamente el efecto de la longitud histórica.
En tercer lugar, deben ser variables valoradas directamente por el mercado, derivadas de precios y rendimientos negociados y no de encuestas o publicaciones macroeconómicas.
Esto permite que estén disponibles en tiempo real, estén sujetas a pocas revisiones y reflejen la propia evaluación del riesgo realizada por el mercado.
Todos los datos proceden de dos fuentes gratuitas: Kenneth French Data Library —factor diario de mercado y carteras de 12 industrias— y FRED —rendimientos de bonos corporativos—.
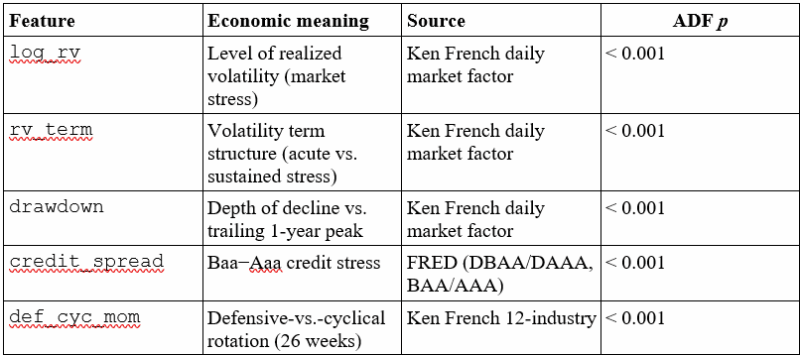
El resultado son cinco variables que cubren cuatro canales económicos diferentes de riesgo.
Tres se calculan a partir de la rentabilidad diaria del mercado total y del índice de precios correspondiente.
log_rv, el logaritmo de la volatilidad realizada a 21 días, captura el nivel de estrés del mercado.
Es la señal de régimen individual más informativa y la que presenta una reversión a la media más fuerte.
rv_term, el logaritmo de la ratio entre la volatilidad realizada a 21 y 63 días, captura la estructura temporal de la volatilidad.
Un fuerte repunte de la volatilidad de corto plazo frente a la de mayor horizonte identifica episodios de estrés agudo y de rápida evolución y actúa como sustituto independiente de modelo para la pendiente de la curva de volatilidad implícita.
drawdown, el precio relativo a su máximo del último año, captura la profundidad de una caída en curso y, por construcción, está limitado superiormente a cero.
Las otras dos variables amplían el análisis más allá del índice.
credit_spread, la diferencia entre los rendimientos corporativos Baa y Aaa, captura el estrés transmitido a través de los mercados de crédito, que puede ampliarse independientemente de la volatilidad de la renta variable.
def_cyc_mom captura la rotación transversal: la rentabilidad relativa de las últimas 26 semanas de una cesta de sectores defensivos frente a otra de sectores cíclicos.
Esta variable se vuelve positiva a medida que los inversores se desplazan hacia activos más defensivos.
En conjunto, estas cinco variables describen el riesgo mediante la volatilidad, su estructura temporal, el nivel de precios, el crédito y el liderazgo sectorial.
Varias decisiones de construcción son importantes para mantener la credibilidad del estudio.
Todas las variables se muestrean semanalmente, los viernes, y todas las ventanas móviles utilizan exclusivamente datos históricos.
Ninguna observación incorpora información futura.
El spread de crédito se construye combinando dos series: la serie diaria Baa−Aaa comienza únicamente en 1986, por lo que para el periodo anterior se utiliza la serie mensual, extendida sobre la frecuencia semanal.
Cuando existen datos diarios, estos tienen prioridad.
Las cestas defensiva y cíclica también implican una decisión deliberada.
Como sectores defensivos se utilizan bienes de consumo no duraderos, salud y utilities.
Como sectores cíclicos se incluyen bienes duraderos, manufacturas, equipamiento empresarial, comercio minorista y finanzas.
Energía, “otros” y algunos grupos ambiguos se dejan sin clasificar en lugar de forzarlos artificialmente hacia uno de los dos grupos.
El panel semanal completo se extiende desde 1962 hasta la actualidad.
La Tabla 1 resume el panel y confirma el requisito de estacionariedad.
Una prueba aumentada de Dickey–Fuller rechaza la hipótesis nula de raíz unitaria a niveles convencionales para las cinco variables.
El spread de crédito es la variable más persistente, algo lógico en una serie vinculada a ciclos crediticios de evolución lenta.
Diseño del experimento
Se fija una única división cronológica para todo el estudio.
Existe un conjunto de entrenamiento entre 1962 y 2009, una ventana de prueba entre 2010 y 2023 y un periodo holdout completamente separado desde 2024 en adelante.
Sobre esta estructura común se ajustan cuatro modelos candidatos que únicamente difieren en la fecha de inicio de su entrenamiento: 1970, 1980, 1990 o 2000.
Todos terminan su entrenamiento en la misma frontera temporal antes de 2010.
Como cada variante se evalúa posteriormente sobre exactamente la misma ventana de prueba, la cantidad de historia utilizada es la única variable que cambia.
Esto permite analizar limpiamente la relación entre la fecha inicial del entrenamiento y el comportamiento fuera de muestra.
Las fronteras utilizadas para dividir los datos son también una decisión deliberada y terminan siendo importantes.
La ventana de prueba incluye episodios reales de estrés: el crash de la pandemia de 2020 y el mercado bajista de 2022.
Así, el rendimiento fuera de muestra refleja cómo se comporta el modelo durante crisis reales y no únicamente durante una expansión tranquila.
El periodo holdout comienza en 2024 y corresponde a una etapa reciente de menor volatilidad.
Se mantiene completamente apartado tanto del ajuste como de la selección y únicamente se utiliza una vez para la evaluación final.
Como veremos posteriormente, la elección de dónde colocar la frontera de validación termina siendo tan importante como la longitud del historial que se pretende estudiar.
El modelo utilizado en todos los casos es un HMM gaussiano de cuatro estados con covarianza completa.
El número de estados se determina utilizando el criterio de información bayesiano y la interpretabilidad económica.
Cuatro estados permiten identificar claramente un régimen tranquilo, uno normal, una corrección y una crisis.
Añadir más estados tiende simplemente a dividir el régimen tranquilo en variantes casi idénticas sin aportar significado económico adicional.
Se utiliza covarianza completa y no diagonal porque las variables están correlacionadas: la volatilidad se mueve junto con el drawdown y los spreads de crédito.
Un modelo diagonal representaría de forma incorrecta la estructura de cada nube de emisiones.
Los parámetros se estiman mediante Baum–Welch con múltiples reinicios aleatorios, ya que la función de verosimilitud no es convexa y un único ajuste podría quedar atrapado en un óptimo local deficiente.
La disciplina aplicada a la evaluación es precisamente lo que diferencia este estudio de un backtest diseñado para favorecerse a sí mismo.
La estandarización se ajusta únicamente sobre la ventana de entrenamiento de cada variante y posteriormente queda congelada.
Los conjuntos de prueba y holdout se transforman utilizando esas mismas estadísticas.
Nunca utilizan sus propias medias o desviaciones para normalizarse.
Los parámetros del HMM también quedan congelados después del ajuste y nunca se vuelven a estimar utilizando datos de evaluación.
El holdout permanece sellado: no interviene ni en el entrenamiento ni en la selección y se decodifica únicamente al final.
Toda la evaluación utiliza la estimación filtrada del régimen, condicionada exclusivamente a los datos disponibles en cada momento.
De esta forma, ninguna señal puede beneficiarse de información futura.
Existe además una dificultad adicional porque cada variante utiliza su propia estandarización.
Una verosimilitud calculada en espacio estandarizado no puede compararse directamente entre modelos.
Por eso, las verosimilitudes de prueba se expresan en el espacio original de las variables, corrigiendo por el jacobiano del escalado, para conseguir una comparación justa.
Finalmente, la forma de puntuar cada variante durante la prueba es una decisión de modelización y no una simple cuestión mecánica.
El modelo puede clasificarse según su ajuste estadístico —la verosimilitud fuera de muestra— o mediante un criterio relacionado con su uso práctico, como la rentabilidad ajustada al riesgo bajista de la estrategia derivada de sus regímenes.
Ambos criterios no tienen por qué coincidir.
Y en este estudio, de hecho, no coinciden.
Ajuste y regímenes identificados
Con el diseño ya establecido, cada variante se estima y posteriormente se decodifican sus regímenes a lo largo de toda la muestra.
La Figura 1 muestra simultáneamente las cuatro ventanas de entrenamiento: el precio del mercado en escala logarítmica, sombreado según el régimen asignado a cada semana, y la ventana de prueba claramente identificada.
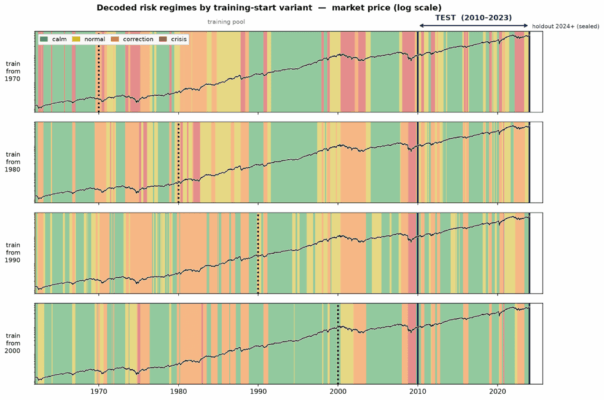
Cada panel ajusta el HMM de cuatro estados utilizando una ventana diferente —comenzando en 1970, 1980, 1990 o 2000— y decodifica posteriormente la secuencia de regímenes hasta la ventana común de prueba.
El periodo holdout posterior a 2024 permanece sellado y no se muestra.
El color de fondo corresponde al régimen filtrado y la línea negra representa el precio de mercado.
La figura permite extraer varias conclusiones importantes.
En primer lugar, los regímenes tienen una interpretación económica clara.
El estado de crisis coincide con todos los grandes episodios históricos: 1973-74, 1987, 2000-02, 2008, 2020 y 2022.
Los estados de corrección y crisis se concentran alrededor de los drawdowns visibles, mientras que los estados tranquilo y normal dominan durante las grandes expansiones.
En segundo lugar, y de forma central para la pregunta principal, los cuatro paneles son generalmente consistentes pero no idénticos.
El punto de inicio del entrenamiento cambia la forma en que el modelo segmenta las primeras décadas.
Un modelo que nunca entrenó con los años setenta está extrapolando cuando intenta interpretar ese periodo.
La variante que comienza en 1970 —y que ha observado toda la variedad de regímenes— clasifica con mayor confianza las primeras crisis.
Las variantes que comienzan más tarde tienen que interpretar esos episodios fuera de la distribución sobre la que fueron entrenadas.
Este es el efecto de la longitud histórica mostrado visualmente.
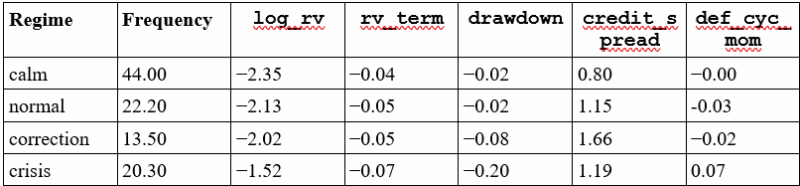
Analizando las medias de las variables, los cuatro estados no forman simplemente una escala de volatilidad creciente, sino cuatro perfiles de riesgo diferenciados.
Los estados tranquilo y normal presentan ambos baja volatilidad y se diferencian principalmente por los spreads de crédito y la rotación sectorial.
El estado de corrección es principalmente un régimen de estrés crediticio, con los spreads más amplios de todo el panel y únicamente una volatilidad moderada en renta variable.
Este estado captura episodios como los elevados spreads observados a comienzos de los años ochenta.
El estado de crisis representa fundamentalmente estrés en la renta variable, con la mayor volatilidad realizada y los drawdowns más profundos.
Es el régimen en el que aparecen episodios como 1987, 2008 y 2020.
El hecho de que la distinción más informativa sea entre estrés de crédito y estrés de renta variable, y no simplemente una escala única de intensidad, constituye por sí mismo un resultado útil del modelo.
Tabla 2: Huellas de los regímenes
¿Ayuda utilizar más historia?
Las cuatro variantes se comparan utilizando la misma ventana de prueba.
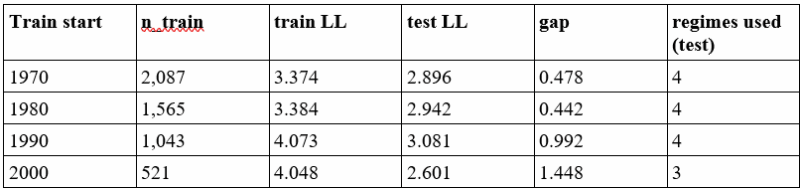
Si clasificamos los modelos mediante la verosimilitud fuera de muestra —la métrica escalar más evidente—, el modelo recomendado sería uno de los que utilizan menos historia: el que comienza en 1990.
Tomado literalmente, este resultado respondería negativamente a la pregunta del título: más historia no ayudaría.
Sin embargo, dos parámetros contradicen claramente esa interpretación.
El primero es el número de regímenes que cada modelo utiliza realmente fuera de muestra.
Prácticamente solo la variante entrenada desde 1970 utiliza los cuatro estados durante la prueba.
Los modelos con historiales más cortos apenas utilizan el estado de crisis o directamente se reducen a tres estados, dejando vacío el régimen de crisis.
Para un modelo cuya finalidad es precisamente identificar crisis, tener un estado de crisis vacío no es un pequeño defecto: es el fallo central del modelo.
El segundo parámetro es la diferencia entre la verosimilitud dentro y fuera de muestra.
Esta diferencia es menor en las variantes que comienzan en 1970 y 1980 y aumenta progresivamente a medida que se acorta la ventana de entrenamiento.
Ese comportamiento es característico del sobreajuste.
Los modelos entrenados con menos historia encajan muy bien sobre sus periodos recientes y tranquilos, pero no consiguen trasladar correctamente ese ajuste hacia el futuro.
La razón por la que la métrica estadística simple resulta engañosa es estructural.
La verosimilitud fuera de muestra es un promedio calculado sobre toda la ventana de prueba.
Y prácticamente cualquier ventana realista está compuesta mayoritariamente por semanas tranquilas.
Incluso cuando deliberadamente se incluyen las fuertes caídas de 2020 y 2022, estos episodios siguen representando únicamente una pequeña proporción de todas las observaciones.
Por tanto, el modelo recibe una gran recompensa por ajustar correctamente la mayoría tranquila y una penalización mínima por clasificar incorrectamente las pocas semanas que realmente importan.
La corrección tiene dos elementos.
En primer lugar, situar episodios reales de estrés dentro de la ventana de validación otorga al menos cierto peso a la capacidad de detectar crisis.
Pero, de forma todavía más importante, clasificar los modelos mediante un criterio alineado con su finalidad práctica —la rentabilidad ajustada al riesgo bajista de la estrategia derivada de los regímenes— cambia completamente el resultado.
Bajo este criterio, el modelo entrenado con el historial más largo es el que mejor generaliza, precisamente porque es el único que ha observado todo el rango histórico de regímenes.
La respuesta a la pregunta del título es, por tanto, sí: más historia ayuda.
Permite que el modelo desarrolle realmente un estado de crisis y reduce el riesgo de sobreajustarse a una ventana reciente y tranquila.
Sin embargo, esta conclusión resulta invisible utilizando la métrica que parecería más natural.
Un profesional que seleccionara únicamente por verosimilitud fuera de muestra durante una década tranquila habría elegido un modelo sobreajustado e incapaz de reconocer correctamente las crisis y habría concluido erróneamente que la historia antigua simplemente introduce ruido.
La cuestión de la longitud histórica no puede separarse de la metodología utilizada para evaluarla.
El periodo de validación y la métrica de puntuación determinan la respuesta al menos tanto como la propia longitud del entrenamiento.
Tabla 3: Comparación según longitud histórica
La verosimilitud por observación se calcula en el espacio original de las variables.
La diferencia entre entrenamiento y prueba aumenta con el sobreajuste.
Si únicamente se utiliza la verosimilitud, el modelo que comienza en 1990 aparece en primer lugar.
¿Funciona como estrategia?
Determinar si los regímenes existen realmente es una cuestión distinta de comprobar si pueden utilizarse de manera rentable.
Y esta segunda pregunta resulta especialmente fácil de responder de manera engañosa.
Un modelo que reduce su exposición a renta variable durante los estados de corrección y crisis asumirá automáticamente menos riesgo que una estrategia completamente invertida.
En una muestra que contenga grandes drawdowns, normalmente mostrará un ratio Sharpe superior únicamente por ese motivo.
Por eso, la pregunta relevante no es si la estrategia supera a comprar y mantener.
La verdadera pregunta es si supera a una versión equivalente que reduzca el riesgo en la misma cantidad pero sin utilizar ninguna información sobre regímenes.
Si no puede hacerlo, su aparente habilidad simplemente está disfrazando una reducción de beta.
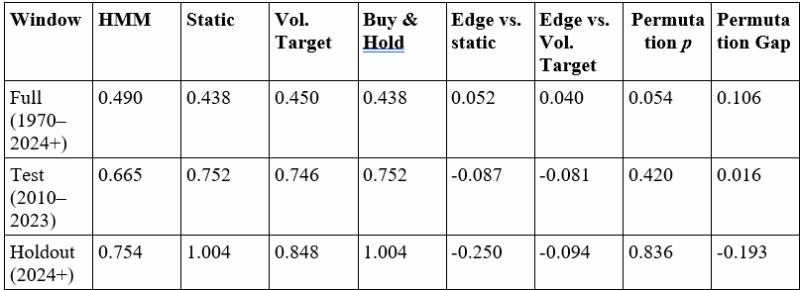
La estrategia basada en regímenes se compara con dos alternativas que no utilizan información sobre estados de mercado.
La primera es una cartera estática ajustada para tener la misma exposición media.
La segunda es una cartera con objetivo de volatilidad que modifica su exposición en función de la inversa de la volatilidad realizada.
También se aplica una prueba de permutación que reorganiza los bloques de regímenes manteniendo su duración.
El resultado es modesto.
La ventaja de la estrategia frente a su equivalente estático es ligeramente negativa.
Su Sharpe tampoco supera al de la estrategia basada simplemente en objetivo de volatilidad.
Además, la prueba de permutación no permite rechazar la hipótesis nula: el Sharpe real se sitúa por debajo de la media obtenida al reorganizar aleatoriamente los regímenes históricos.
El HMM sí reduce el drawdown máximo.
Realmente mantiene menos exposición durante las crisis.
Pero no existe evidencia de que posea capacidad de market timing más allá de la que ya captura una regla sencilla de volatilidad.
Reduce riesgo; no anticipa el mercado.
Un clasificador de regímenes puede identificar algo real, como ocurre claramente en este caso, y aun así no proporcionar una ventaja directamente operable.
Tabla 4: Market timing frente a reducción de riesgo
La cartera estática mantiene la exposición media de la estrategia utilizando un calendario fijo.
Su ratio Sharpe es, por construcción, equivalente al de una estrategia de comprar y mantener, por lo que constituye el punto de referencia que debe superar el HMM.
La métrica Edge vs. static permite separar la capacidad de timing de la mera reducción de riesgo.
Conclusión
El experimento preguntaba si un modelo de regímenes de mercado se beneficia de utilizar más historia durante su entrenamiento.
La respuesta es un sí con matices.
Más historia ayuda: la variante con el periodo histórico más largo es la única que representa correctamente los cuatro regímenes fuera de muestra y la única que evita sobreajustarse a una ventana reciente y tranquila.
Pero este beneficio solo puede observarse cuando la metodología de evaluación está diseñada para detectarlo.
La conclusión más duradera del estudio es metodológica.
Una única métrica aparentemente natural ofreció una respuesta clara, pero equivocada.
La respuesta correcta apareció únicamente al utilizar un criterio alineado con el uso real del modelo.
La verosimilitud fuera de muestra recomendaba el modelo sobreajustado e incapaz de identificar correctamente las crisis.
La evaluación del número de regímenes realmente utilizados y de la diferencia entre entrenamiento y prueba corrigió esa conclusión.
La elección decisiva fue el criterio de evaluación, no el modelo.
Para los modelos de regímenes, esto significa que la selección del periodo de validación y de la métrica de puntuación puede tener tanto valor como la longitud del entrenamiento, el número de estados o el conjunto de variables, aspectos que normalmente reciben mucha más atención.
En cuanto al propio modelo, es un clasificador competente pero una estrategia poco extraordinaria.
Sus regímenes encajan con la historia y tienen sentido económico, pero reducen riesgo en lugar de anticipar el mercado y no superan una simple regla basada en volatilidad.
Un modelo puede estar identificando claramente algo real y, aun así, no ofrecer ninguna ventaja operable.
Eso no representa un fracaso del experimento, sino probablemente su conclusión más instructiva, visible precisamente porque la evaluación fue diseñada para revelar las limitaciones del modelo y no para favorecerlo.
Autor: Julián Jalšovský, analista cuantitativo de Quantpedia.